前言
关于 AI 发展速度的争论正在越来越多地从技术圈进入公共政策和社会讨论。近期 Anthropic CEO Dario Amodei 公开呼吁前沿 AI 开发适当放慢,以便安全能力能够追上模型能力;这一观点得到包括 OpenAI CEO Sam Altman 等行业人士的部分支持。
与此同时,关于 AI 是否应该由企业自行决定发展速度、政府应该承担多少监管责任的讨论也在持续。这些争议表面上围绕“快还是慢”,但如果把时间维度拉长,会发现一个更加值得研究的问题:当 AI 能力不断增强之后,什么能力必须同步增长?
答案很可能不是另一个更强的模型,而是安全评估、权限控制、监控、审计、隔离和人工监督等基础设施。
2026 年 International AI Safety Report 将前沿 AI 的能力与风险放在同一个框架下讨论,并指出随着系统能力扩大,需要不断调整风险缓解方式。 这意味着 AI 安全正在逐渐从“研究团队里的附加工作”变成 AI 系统规模化部署的基础条件。
核心要点
-
AI 能力增长越快,安全能力与治理能力越不能停留在原有水平
-
Agent 化让 AI 安全从模型层延伸到工具、权限和执行环境
-
独立评估和持续监控可能成为前沿 AI 部署的重要基础设施
-
AI Safety 不只是合规成本,也可能成为企业规模化使用 AI 的前提
-
长期竞争可能从单纯的模型能力扩展到“安全地使用模型能力”
AI 安全为什么正在改变定义
早期 AI 安全更多讨论模型是否产生有害内容、是否存在偏见、是否会给出错误信息。这些问题仍然重要,但随着模型越来越能够执行任务,安全问题的边界已经扩大。
一个能够写文章的模型和一个能够访问企业数据库、调用 API、执行代码的 Agent,风险结构完全不同。后者即使只出现一次错误,也可能产生真实业务后果。
AI 能力边界的变化,也意味着安全问题正在发生一次结构性迁移。传统 AI 产品主要关注的是模型“说了什么”,因此安全机制往往集中在训练数据、内容过滤、输出审核和模型评测等环节。但当 AI 开始拥有长期记忆、外部工具、企业数据访问权限以及自主执行能力之后,真正需要控制的就不再只是输出内容,而是 AI 能够“看到什么、调用什么、修改什么以及最终能够产生什么结果”。模型本身即使没有生成明显有害的内容,也可能因为权限配置不合理或工具调用失控而产生实际风险。
因此,未来的 AI Safety 更接近一套完整的系统工程,而不是单一的模型能力。模型安全仍然是第一层基础,但在其之上还需要增加 Evaluation、Monitoring、Identity & Permissions、Tool Control 和 Human Oversight 等机制。每增加一层能力,AI 能够影响的现实范围就会扩大,相应的安全边界也需要同步外移。这也是为什么企业部署 AI Agent 时,真正困难的部分往往并不是让模型完成一次任务,而是让它在拥有足够执行能力的同时,又始终处于可观察、可限制和可追责的环境之中。
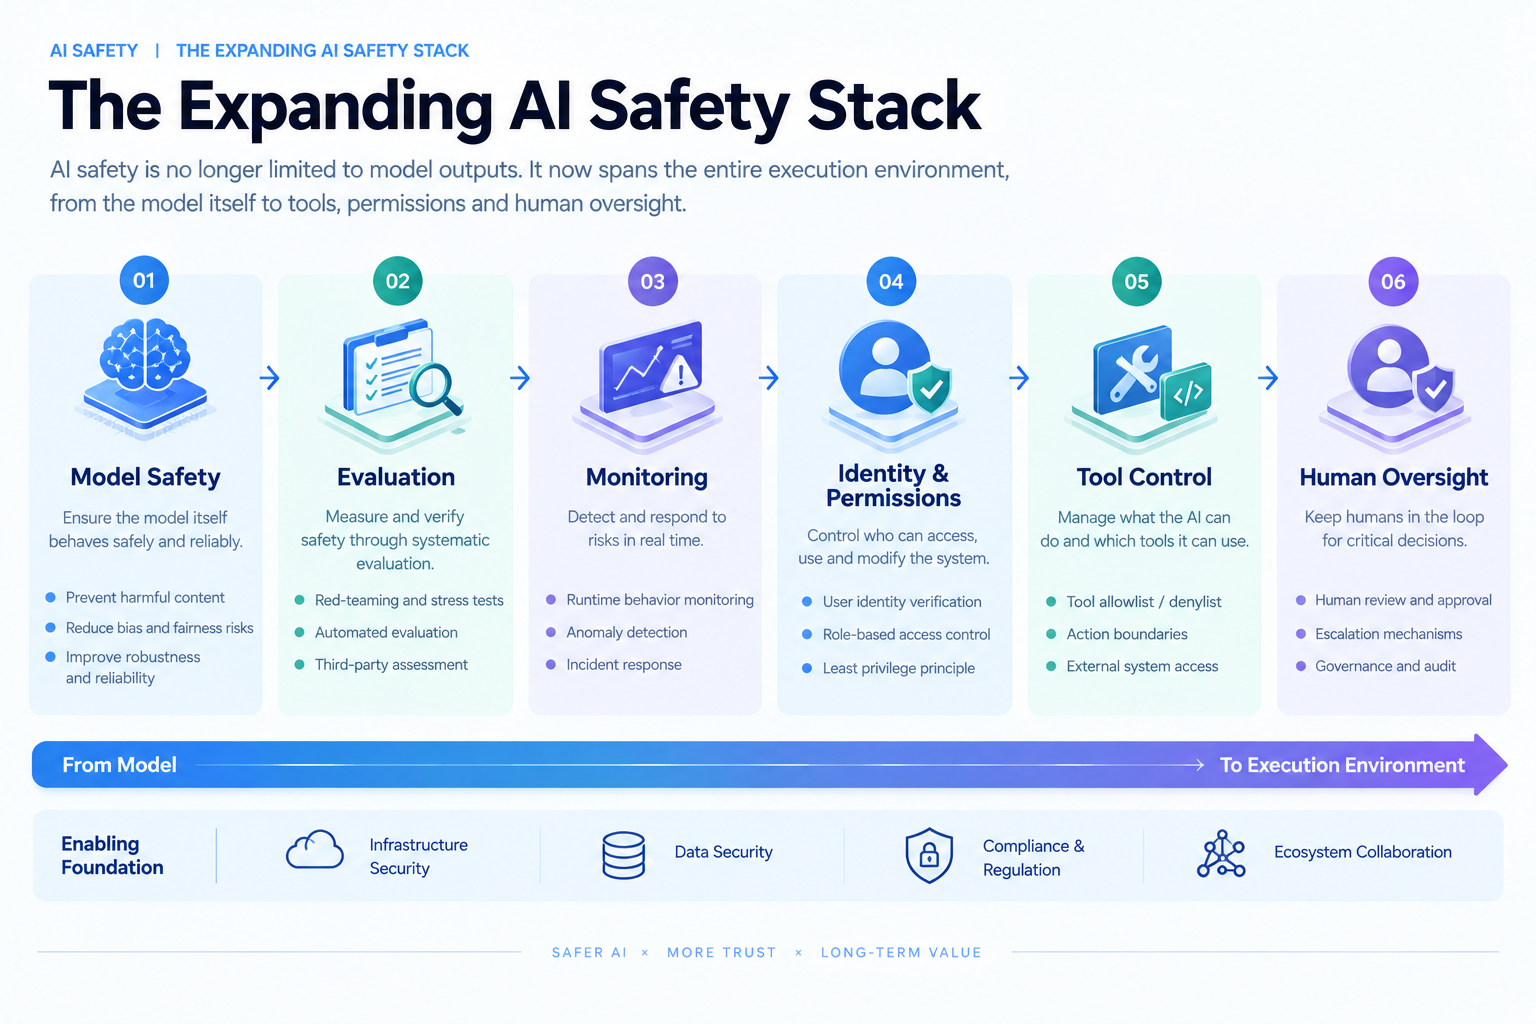
这样说来,未来 AI 安全不能只判断“模型回答了什么”,还必须判断“模型能够做什么”。
这意味着安全能力开始进入身份认证、工具权限、网络隔离、数据访问、操作审计和人工审批等基础设施层。
Agent 让安全问题从“输出”变成“行动”
Agent 是这一变化最重要的推动因素之一。
其中一个容易被忽略的变化,是“权限”可能逐渐成为 AI 安全体系中的核心变量。对于传统软件而言,权限通常由用户身份和角色决定;而对于 AI Agent 来说,系统还需要判断一个动态的问题:AI 在当前任务中究竟应该获得多大的操作空间。例如,一个负责整理销售数据的 Agent 可能需要读取 CRM,但并不应该拥有修改客户账户或直接发起付款的权限。随着 Agent 能够调用的工具越来越多,权限管理也就从传统的“谁可以访问系统”进一步变成“AI 在什么情况下可以执行什么动作”。
这会进一步改变企业评价 AI 系统的方式。过去,企业采购 AI 产品时可能主要比较模型能力、准确率和使用成本;但在 Agent 化之后,企业还需要关注系统是否具备细粒度权限控制、完整操作日志、异常检测、人工审批以及快速撤销能力。换句话说,一个能够完成更多工作的 AI,并不一定意味着它更适合企业环境。真正具有长期价值的系统,需要在“能力上限”和“风险边界”之间建立稳定的平衡,让企业能够逐步扩大 AI 的工作范围,而不是一次性把大量高风险权限交给模型。
传统聊天模型的主要输出是文字或代码,而 Agent 可以围绕一个目标不断调用工具、读取数据、执行任务并根据反馈继续行动。能力越强,Agent 能够承担的任务越复杂;但与此同时,错误执行带来的风险也越高。
这也是为什么近期 AI 安全讨论越来越强调外部评估、监控和执行控制。Anthropic 当前的 Responsible Scaling Policy 就是把模型能力提升与安全措施升级联系起来的一种制度化尝试。
从企业角度看,这意味着 AI 安全的核心问题正在发生转移:过去企业担心“AI 会不会说错”,未来企业更需要担心“AI 有没有权限做错”。
因此,Agent 时代的安全基础设施需要覆盖数据访问、工具调用、操作审计以及人工接管等多个环节,让企业能够明确知道 Agent 在什么范围内行动,以及什么时候必须停止自主执行。
独立评估为什么重要
如果 AI 公司既负责开发模型,又负责评价模型,那么安全评估天然存在利益冲突。
这并不意味着企业内部评估没有价值。恰恰相反,企业内部测试通常拥有最完整的模型信息和工程资源。但当模型能力越来越接近关键基础设施时,外部评估可以提供另一层验证。
近期围绕前沿 AI 开发速度的讨论中,独立安全评估正是一个重要主张。Amodei 提出的框架就包含让外部评估机构获得更深入访问权限的建议。
从长期看,这可能形成类似金融审计和网络安全审计的专业服务体系。模型发布之前,需要通过能力评估;模型上线之后,需要持续监控;发生异常时,需要能够追踪和响应。
这样一来,AI 安全就不再只是模型公司的内部研究问题,而会形成独立产业。
安全能力可能成为 AI 商业化的“第二曲线”
很多企业讨论 AI 时,第一反应是模型能力和生产率。但对于大型机构而言,真正限制 AI 部署速度的可能并不是模型是否够聪明,而是企业是否敢把重要业务交给它。
从产业发展的角度看,这种变化也可能催生一套新的 AI 安全基础设施市场。未来企业可能不仅需要购买模型和计算资源,还需要围绕 AI Agent 建立独立的身份认证、权限管理、运行监控、工具控制、审计和风险评估系统。它们与传统网络安全存在交集,却又并不完全相同,因为 AI 系统的行为具有一定的不确定性,而且同一个 Agent 可能同时连接多个数据源、软件系统和外部工具。安全厂商因此需要解决的不只是“阻止未经授权的访问”,还包括判断 AI 的行为是否符合任务目标、权限范围和企业政策。
这也意味着,AI Safety 的价值最终可能并不体现在某一个单独的安全指标上,而体现在企业是否敢于把 AI 放进更重要的业务流程。对于金融、医疗、企业软件、科研和关键基础设施等领域而言,模型能力只有在风险可以被理解和控制的情况下,才能真正转化为生产力。长期来看,AI 产业的竞争因此可能出现一个重要变化:领先者不只是拥有更强的模型,也可能是那些能够让模型在复杂现实环境中可靠运行、持续受到约束,并且在出现异常时迅速被发现和纠正的系统。
因此,AI 安全实际上可能成为商业化的第二曲线。模型能力决定“AI 能做什么”,安全基础设施决定“企业敢让 AI 做什么”,两者共同决定 AI 能够产生多少经济价值。
安全与创新不是简单的对立关系
把 AI 安全理解为“让 AI 发展慢下来”并不完整。
更成熟的思路是让开发速度和安全能力形成动态匹配。如果某种能力已经达到高风险水平,那么安全措施必须同步升级;如果新的评估工具可以降低风险,那么企业就能够更放心地扩大部署。
因此,真正值得长期研究的不是“AI 应不应该停止发展”,而是有没有办法建立一套能够随着能力增长自动升级的安全体系。
这也是为什么未来 AI 产业可能逐渐出现一个新的竞争维度:
谁能够以更低的安全成本,把更强的模型部署到更多真实场景?
这比简单比较 benchmark 分数更接近 AI 商业化的终局。
FAQ
AI Safety 和 AI Governance 是一回事吗?
不是。AI Safety 更关注模型和系统可能产生的技术与现实风险,而 Governance 更广泛,包括责任、制度、组织、监管和决策机制。两者会越来越紧密地结合。
为什么 Agent 会提高 AI 安全的重要性?
因为 Agent 不只是生成信息,而是可以执行操作。当 AI 获得数据访问、软件工具和外部系统权限后,风险从“错误答案”扩展到了“错误行动”。
AI 安全投入会不会降低 AI 企业竞争力?
短期可能增加成本和研发摩擦,但长期看,如果安全能力能够降低事故、合规和部署风险,它也可能成为 AI 企业扩大商业化规模的重要条件。
* 投资有风险,入市须谨慎。本文不作为 Gate 提供的投资理财建议或其他任何类型的建议。
* 在未提及 Gate 的情况下,复制、传播或抄袭本文将违反《版权法》,Gate 有权追究其法律责任。
分享


相关文章

CKB:闪电网络促新局,落地场景需发力
ONDO 代币经济模型:如何激励平台增长与参与?
什么是加密货币中的完全稀释估值(FDV)?
GateClaw 与 AI Skills:Web3 AI Agent 的能力体系解析
JTO 代币经济学解析:分配、用途与长期价值