


Pearl 是一条采用 Proof-of-Useful-Work(PoUW)的 Layer 1 区块链,其核心挖矿机制利用 GPU 执行矩阵乘法(Matrix Multiplication),让 GPU 计算同时参与区块链工作量证明和 AI 计算基础设施。与传统 PoW 主要依靠 SHA-256 等哈希运算不同,Pearl 的设计重点是让 GPU 原本擅长的计算操作成为网络共识的一部分。
AI 模型训练与推理对 GPU 的需求持续增长,使 GPU 算力逐渐从单纯的计算资源变成一种具有经济价值的基础设施。Pearl 的设计正是建立在这一变化之上:矿工提供 GPU 计算能力,网络根据经过验证的 Work 给予 PRL 奖励,而 AI 计算则为这些 GPU 资源提供潜在的额外使用场景。
因此,理解 Pearl 的挖矿机制,不能只看“什么 GPU 算力最高”,还需要同时理解区块奖励、网络难度、发行曲线和矿池分配方式。对于矿工而言,真正决定收益的并不是 GPU 的绝对算力,而是 GPU 算力在整个网络中的占比,以及单位计算资源能够获得的 PRL 奖励。
核心要点
-
Pearl 的挖矿核心是 GPU 矩阵计算。 Pearl 通过 Proof-of-Useful-Work 将 Matrix Multiplication(MatMul)引入 PoW,使 GPU 执行的计算成为网络工作量证明的一部分。
-
GPU 性能会直接影响矿工获得 Work 的能力。 当前公开矿工软件已经支持 NVIDIA RTX 30 系列及更新架构,公开测试数据显示 RTX 4090、H100 等设备具有明显不同的 Pearl 算力水平,但实际表现会受到功耗、温度、软件版本和矿池难度影响。
-
Pearl 的区块奖励不是固定数量。 网络采用多项式衰减发行机制,区块补贴会随区块高度持续变化,而不是按照 Bitcoin 的周期性减半方式调整。
-
PRL 最大供应量为 21 亿枚。 白皮书将 21 亿枚设定为完全稀释后的总供应量,并通过发行曲线控制不同阶段的代币释放速度。
-
挖矿收益不能只看 GPU 算力。 网络总算力、难度、当前区块补贴、PRL 价格、设备功耗以及电价都会影响最终挖矿经济性,因此单纯比较不同 GPU 的理论算力并不能直接得出实际收益。
Pearl 挖矿需要什么 GPU 与硬件条件
Pearl 的挖矿设计以 GPU 为核心,因此显卡是参与网络计算的主要硬件。目前 Pearl 官方矿工代码包含 CUDA、GPU Mining 和 vLLM 相关组件,官方仓库的矿工文档要求 NVIDIA GPU 和 CUDA 环境。公开代码测试中,目前 pearl-gemm 和 vllm-miner 的部分测试针对 NVIDIA Hopper 架构的 H100 / H200。 与此同时,社区矿工软件已经将支持范围扩展到更多 NVIDIA GPU。
例如 6block 的 Pearl Miner README 显示,其软件支持 NVIDIA 30 系列及更新架构,包括 Ampere、Ada 和 Hopper,并列出了 RTX 3080、RTX 3090、RTX 4090 与 H100 的典型算力。其公开数据中,RTX 3080 约为 112 TH/s,RTX 3090 约为 120 TH/s,RTX 4090 约为 305 TH/s,H100 约为 760 TH/s。需要注意,这些属于特定矿工软件和测试环境下的典型数据,而不是 Pearl 协议规定的固定算力标准。
GPU 的实际挖矿表现还会受到显存、功耗、核心频率、散热、驱动版本以及矿工软件优化等因素影响。例如同一型号 GPU,在不同功耗限制和环境温度下可能产生不同的有效算力。因此,判断设备是否适合 Pearl 挖矿时,需要同时考虑算力与单位功耗。 除了 GPU 之外,矿工还需要准备运行节点或连接矿池所需的软件环境。Pearl 官方节点支持 getblocktemplate RPC,并要求挖矿奖励地址使用 Taproot 地址。
PRL 矿工如何参与 Pearl 网络
Pearl 矿工的基本流程与其他 PoW 网络具有一定相似性,但核心计算任务不同。 矿工首先需要创建 Pearl 钱包地址,并配置挖矿奖励地址。之后可以运行 Pearl 节点,将节点与网络连接;如果采用矿池模式,则可以通过支持 Pearl 的矿工软件连接 Stratum 等矿池协议。 在单独运行节点时,Pearl 官方文档要求配置 miningaddr,用于指定接收挖矿奖励的 Taproot 地址。节点通过 getblocktemplate 等 RPC 向矿工提供区块模板,矿工则利用 GPU 执行符合 Pearl PoUW 要求的计算。 如果使用矿池,流程会进一步简化。矿池负责协调多个矿工,将整个网络的计算任务分配给不同 GPU,再按照矿工提交的有效 Share 或贡献比例进行收益结算。
因此,Pearl 矿工可以大致分成两种参与方式:
-
Solo Mining: 矿工自行运行节点并独立竞争区块,获得区块奖励,但收益波动通常更大。
-
Pool Mining: 多个矿工通过矿池共同参与计算,由矿池协调任务并根据贡献进行收益分配。
对于 GPU 数量较少的参与者而言,矿池模式通常更容易获得相对稳定的收益记录,但具体收益还需要扣除矿池手续费等成本。
Pearl 的区块奖励如何计算
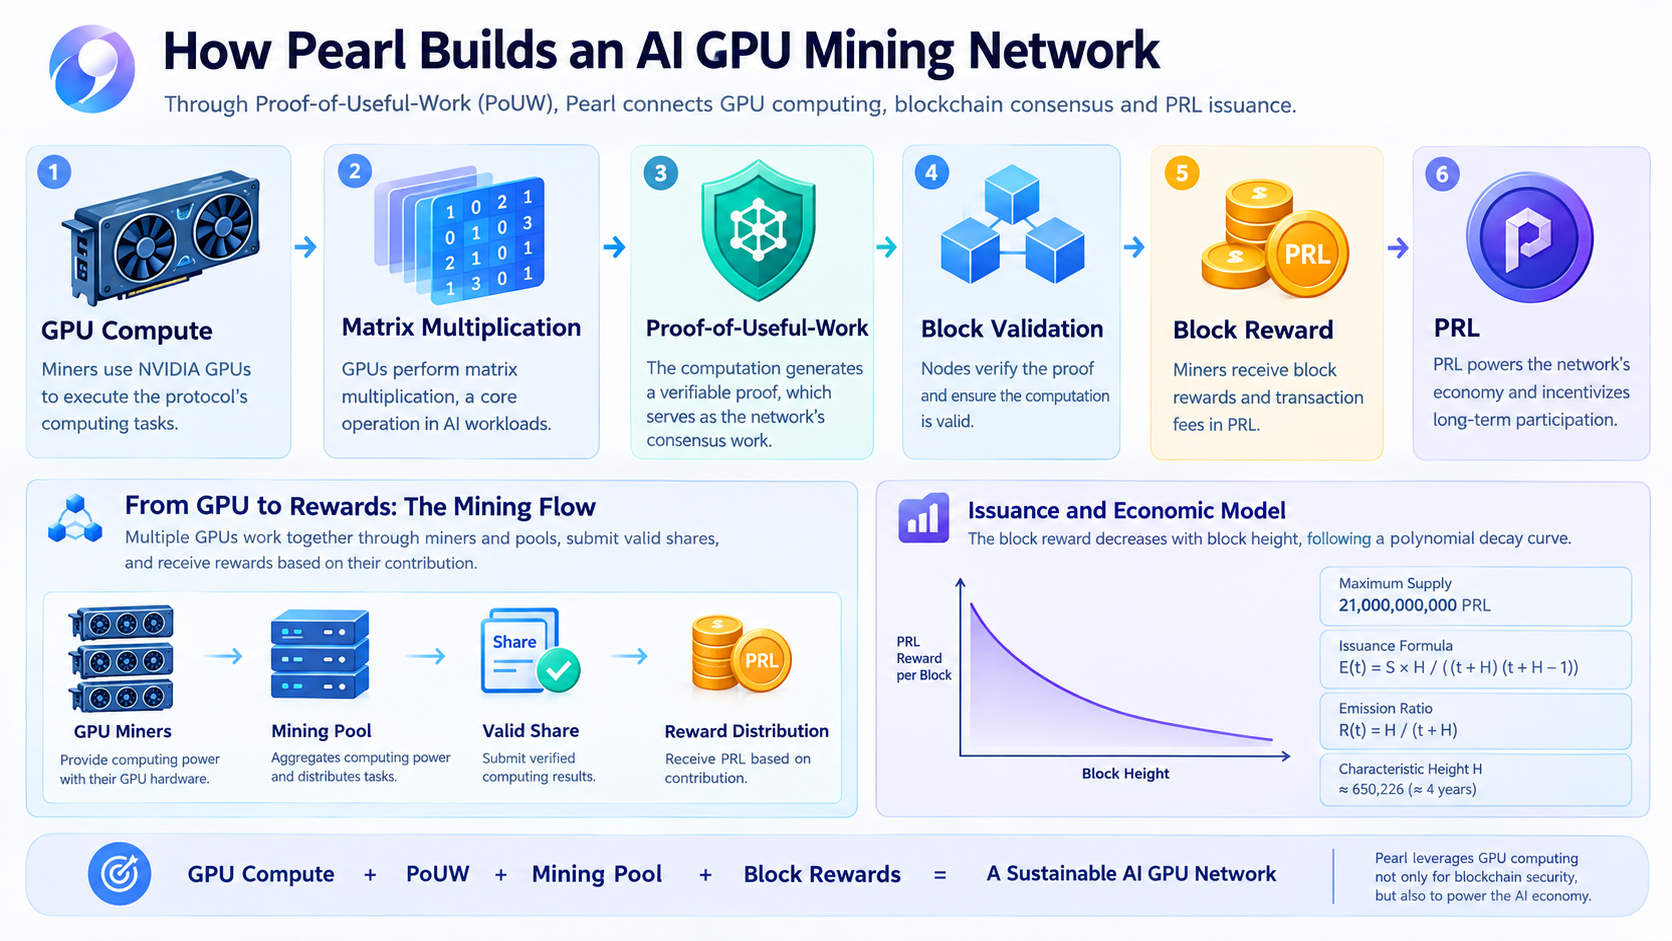
Pearl 的区块奖励由区块补贴(Block Subsidy)和交易手续费构成。其中,区块补贴是 PRL 新发行的重要来源。
Pearl 的一个特点是,区块补贴不会长期保持固定数值。网络采用随区块高度变化的发行公式,因此矿工在不同区块高度获得的理论区块奖励并不完全相同。
Pearl 白皮书给出的区块发行公式为:E(t) = S × H / ((t + H)(t + H − 1))
其中,S 是总供应量,H 是发行曲线的特征区块高度,t 是当前区块高度。实际发行量以最小单位 Grain 进行取整。 这意味着,随着 t 不断增加,每个区块新增的 PRL 会逐渐下降。
从实际网络数据来看,2026 年 9 月的 Pearl 区块已经可以看到具体的区块补贴。例如区块浏览器记录的第 111,276 个区块,区块补贴约为 2,354.74 PRL,同时显示网络难度约为 20.47M、网络算力约为 29.70 EH/s。这个数据可以直观看出,区块奖励、难度和网络算力都是动态变化的。 因此,矿工不能简单使用“当前区块奖励 × 每天区块数量”计算长期收益,因为区块补贴会随着区块高度下降,同时网络算力和难度也会不断变化。
网络难度与 GPU 算力如何影响挖矿效率
Pearl 同样需要通过难度调整机制维持相对稳定的出块时间。白皮书设定的目标区块时间约为 194 秒,也就是约 3 分 14 秒。
网络难度可以理解为矿工竞争区块的门槛。难度上升时,同一 GPU 在单位时间内获得有效区块或有效 Share 的机会会下降;如果难度下降,则相同算力对应的理论产出机会提高。
Pearl 使用 WTEMA(Weighted-Target Exponential Moving Average)进行难度调整,而不是简单采用 Bitcoin 每 2016 个区块调整一次的方式。白皮书认为,更连续的难度调整有助于网络在算力快速变化时保持目标出块时间。
对于矿工而言,可以用一个简化关系理解挖矿效率:个人有效算力占比 ≈ 个人有效算力 ÷ 网络总有效算力。
在其他条件相同的情况下,个人算力占全网算力的比例越高,理论上获得区块奖励的比例也越高。
但实际情况还要考虑矿池 Share、软件效率和硬件功耗。例如一张 GPU 的算力提高 10%,如果同时功耗增加 20%,单位电力成本下的收益未必同步提高。因此,GPU 挖矿更重要的指标通常是 单位功耗算力,而不是单纯的 TH/s。
PRL 的发行机制与最大供应量如何设计
Pearl 将 PRL 的最大供应量设定为 21 亿枚。白皮书将这一数值定义为完全稀释后的总供应量,并通过发行曲线决定不同阶段进入流通的代币数量。
Pearl 的目标并不是让所有 PRL 在网络早期快速进入市场,而是让代币发行与区块高度持续关联。每个区块都会按照当前发行曲线产生相应的区块补贴,随着网络不断运行,单区块新增 PRL 持续下降。
这使得 Pearl 的代币发行与 GPU 挖矿之间形成直接关系:矿工提供符合 PoUW 要求的计算能力,网络产生区块补贴,而区块补贴又构成 GPU 参与网络的经济激励。
这种模式与单纯预挖或一次性发行存在明显差异。PRL 的新增供给主要伴随网络区块产生,矿工需要通过计算工作获得新增代币。
为什么 Pearl 采用随区块高度变化的发行曲线
Pearl 没有采用 Bitcoin 式的固定周期减半,而是采用平滑的多项式衰减发行曲线。
白皮书给出的剩余供应比例为:R(t) = H / (t + H)
其中 H 是特征时间尺度。Pearl 将 H 设置为约 650,226 个区块,对应约四年的区块时间,并使该高度附近的剩余未发行供应量下降至约 50%。 这种设计有两个比较明显的特点。
第一,发行不会在某个固定区块突然下降一半。Bitcoin 的减半机制会产生明确的发行拐点,而 Pearl 的每区块奖励持续变化,因此发行曲线更加平滑。
第二,长期仍然存在较薄但持续的尾部发行。Pearl 白皮书认为,如果长期发行过低,可能降低未来矿工维护网络安全的经济激励,因此设计了更平滑的长期发行结构。
对于矿工来说,这意味着早期挖矿奖励较高,但不能假设当前收益会长期维持。随着区块高度增长,单区块补贴会逐渐下降,矿工需要依靠更高效的硬件、更低的能源成本、网络计算需求或其他收入来源维持经济性。
矿池如何参与 Pearl 网络的算力分配
矿池的作用,是将大量独立 GPU 的计算能力聚合起来。
单个矿工独立挖矿时,是否能够获得区块奖励具有较强随机性。矿池则可以把任务拆分成大量 Share,并根据矿工提交的有效工作量进行收益记录。
目前已经出现多个 Pearl GPU Mining 项目。例如 6block 的 Pearl Miner 支持通过 Stratum 连接矿池,并列出了 Fortune Pool 等矿池入口;其 2026 年 7 月版本还增加了 F2Pool 支持。
对于矿池而言,一个重要问题是如何验证矿工提交的 Share。Pearl 社区开发讨论显示,矿池需要在验证成本、Share 数量和安全性之间进行平衡,因为不能简单相信矿工自报的计算结果,同时也不能让每个 Share 的完整验证成本过高。
因此,矿池并不是单纯的“收益分配平台”,它实际上承担了任务协调、Share 验证、矿工统计和奖励结算等基础设施功能。
Pearl 的 GPU 挖矿与传统 AI GPU 云服务有什么区别
Pearl GPU Mining 与传统 AI GPU 云服务虽然都需要 GPU,但经济模型并不相同。
传统 GPU 云服务的核心模式是 客户支付计算费用,GPU 提供商提供计算资源。例如 AI 公司租用 GPU 运行模型训练或推理,服务商根据时间、GPU 类型或计算量收取费用。
Pearl 的 PoUW 模式则以区块链共识为中心。GPU 矿工执行协议规定的计算并获得 PRL 区块奖励,计算资源首先承担网络安全和发行机制中的 Work。
Pearl 白皮书提出的长期方向,是让 AI 训练和推理与挖矿过程更加紧密地结合。其设计希望将 Mining Kernel 集成到 AI 框架中,使 GPU 在执行正常 AI 计算时,也能够利用空闲计算资源参与 Pearl Mining。
两者的主要区别可以概括为:
| 维度 | Pearl GPU Mining | 传统 AI GPU 云服务 |
|---|---|---|
| 核心目的 | 区块链共识与 PRL 发行 | AI 训练与推理 |
| GPU 收益来源 | 区块奖励、手续费等 | 客户支付的计算费用 |
| 计算任务 | PoUW 规定的计算 | 客户指定的 AI 工作负载 |
| 经济单位 | PRL | 法币或稳定币等 |
| 核心参与者 | 矿工、节点、矿池 | 云服务商、AI 开发者 |
| 资源分配 | 由网络和矿池协调 | 由云平台调度 |
| 网络安全作用 | GPU 算力直接参与 PoW | 通常不承担区块链共识 |
因此,“AI GPU”和“GPU 挖矿”并不是同一个概念。Pearl 的特殊之处,在于尝试把两种经济活动放入同一个 GPU 计算体系中,而其最终能否形成稳定的 AI 计算市场,还取决于真实计算需求、协议效率以及矿工经济性。
总结
Pearl 的 GPU 挖矿机制建立在 Proof-of-Useful-Work 之上,通过 GPU 矩阵计算将计算资源、区块链共识和 PRL 发行连接起来。矿工可以通过运行节点和 GPU Mining 软件参与网络,也可以通过矿池聚合算力,按照贡献获得相应收益。
从硬件角度看,目前公开矿工软件已经覆盖 NVIDIA RTX 30 系列及更新架构,RTX 4090、H100 等设备可以达到较高的公开测试算力,但实际挖矿效率仍受到功耗、温度、软件版本和网络难度影响。
从代币经济角度看,Pearl 最大供应量为 21 亿 PRL,并采用随区块高度逐步下降的多项式发行曲线。其目标是避免传统减半机制带来的突然发行变化,同时保留长期的矿工激励。
对于矿工而言,Pearl 的关键变量可以归纳为 GPU 有效算力、网络总算力、当前难度、区块补贴、PRL 价格、电力成本以及矿池手续费。这些因素共同决定实际挖矿经济性。
更值得关注的是,Pearl 能否进一步把 PoUW 从“GPU 挖矿机制”发展为真正的 AI 计算基础设施。如果 AI 推理与训练能够持续产生实际计算需求,并与 Pearl 的 GPU Mining 机制形成更紧密的结合,那么 GPU 的经济价值可能不再局限于传统 AI 云服务或加密货币挖矿,而是形成一种结合计算服务与区块链激励的新型资源市场。
* 投资有风险,入市须谨慎。本文不作为 Gate 提供的投资理财建议或其他任何类型的建议。
* 在未提及 Gate 的情况下,复制、传播或抄袭本文将违反《版权法》,Gate 有权追究其法律责任。
分享
目录


相关文章

不可不知的比特币减半及其重要性


如何选择比特币钱包?

Master Protocol:激活 BTC 生息潜力
